실전 Rust 프로그래밍 - 웹 스크래퍼 만들기 2편
목차
들어가며
지난 1편에서는 Rust의 reqwest를 이용해 웹 서버에 GET 요청을 보내고, 서버가 보내준 HTML을 문자열 형태로 가져오는 것까지 진행했습니다.
아직 안 보셨다면 먼저 1편부터 보고 오시는 것을 추천드립니다.
지난 편에서 마지막으로 작성했던 프로그램을 실행하면 다음처럼 HTML 전체를 가져올 수 있었습니다.
let html = fetch_html(
    &client,
    TARGET_URL,
)
.await?;

println!("HTML 크기: {} bytes", html.len());
사실 여기까지만 해도 웹 서버와 Rust 프로그램은 적절한 요청과 응답을 주고받는다고 볼 수 있습니다.
문제는 가져온 HTML 안에 우리가 필요로 하는 정보뿐만 아니라 메뉴, 버튼, 이미지, 링크를 비롯한 온갖 내용이 한꺼번에 들어 있다는 것입니다.
우리가 원하는 것은 그중에서도 이런 데이터겠죠.
책 제목
책 상세 페이지 주소
가격
평점
재고
상품 설명
그렇다면 우리는 HTML이라는 거대한 문자열 안에서 원하는 정보만 찾아내야 합니다.
오늘은 그 첫 단계로, scraper 라이브러리를 이용해 HTML 구조를 분석하고 첫 페이지에 있는 책 제목과 상세 페이지 URL을 가져와 보겠습니다.
지난 편의 코드를 다시 확인해봅시다
우선 지난 편의 완성 코드는 다음과 같았습니다.
use reqwest::header::USER_AGENT;
use reqwest::Client;
const TARGET_URL: &str = "https://books.toscrape.com/";
async fn fetch_html(
client: &Client,
url: &str,
) -> Result<String, reqwest::Error> {
let response = client
.get(url)
.header(
USER_AGENT,
"rust-book-scraper/0.1"
)
.send()
.await?
.error_for_status()?;
response.text().await
}
#[::]
async fn main() -> Result<(), reqwest::Error> {
let client = Client::new();
let html = fetch_html(
&client,
TARGET_URL,
)
.await?;
println!("응답을 정상적으로 받았습니다.");
println!("HTML 크기: {} bytes", html.len());
Ok(())
}현재 html이라는 변수에는 웹사이트에서 받아온 HTML 전체가 문자열 형태로 들어 있습니다.
쉽게 생각하면 이런 상태입니다.
Rust 프로그램

html
 └── "<!DOCTYPE html><html>...........</html>"
여기서 책 제목 하나를 찾겠다고 문자열을 처음부터 끝까지 직접 검색할 수도 있겠지만, HTML에는 이미 태그와 속성이라는 훌륭한 구조가 존재합니다.
마치 40개의 사물함 중에 내 이름표가 달린 사물함에 바로 찾아가 내 물건을 꺼낼 수 있는 것처럼, HTML 역시 이러한 이름표를 제공해 줍니다.
이 방법은 HTML을 HTML답게 탐색하는 방법이라고 할 수 있겠습니다.
scraper 라이브러리 추가하기
Rust에서 HTML을 파싱하고 CSS 선택자를 이용해 요소를 찾기 위해 이번에는 scraper라는 라이브러리를 사용하겠습니다.
라이브러리를 추가하기 위해 1편에서는 직접 에디터로 Cargo.toml을 열었던 것 다들 기억하실 텐데요. 이번엔 다른 방법을 사용하려고 합니다.
터미널에서 프로젝트 디렉터리로 이동한 뒤 다음 명령을 실행합니다.
cargo add scraper이렇게 하면, Cargo가 현재 사용할 수 있는 scraper 패키지를 프로젝트 의존성에 추가해줍니다. 따로 라이브러리의 버전을 찾아 지정해주지 않아도 되기 때문에, 더 간편한 방법입니다.
설치가 완료되면 기존에 사용하던 reqwest, tokio와 함께 scraper가 [dependencies] 아래 추가된 것을 확인할 수 있습니다.
[dependencies]
reqwest = "0.12"
tokio = { version = "1", features = ["full"] }
scraper = "..."
버전 번호는 설치 시점에 따라 달라질 수 있습니다.
앞으로 코드에서는 이 라이브러리에서 크게 두 가지 객체를 사용합니다.
use scraper::{Html, Selector};Html은 우리가 받아온 HTML 문자열을 탐색 가능한 HTML 문서로 바꾸는 역할을 합니다.
Selector는 그 문서에서 어떤 HTML 요소를 찾을 것인지 지정하는 역할을 합니다.
하나씩 살펴보겠습니다.
문자열과 HTML 문서는 무엇이 다를까요?
지난 편에서 GET 요청을 통해 가져온 HTML은 Rust 입장에서 그냥 긴 문자열입니다.
예를 들어 다음 HTML이 있다고 해보겠습니다.
<h1>Rust Programming</h1>
<p class="price">£29.99</p>
문자열로 보면 결국 다음과 다르지 않습니다.
"<h1>Rust Programming</h1><p class=\"price\">£29.99</p>"Rust는 이것만 보고 <h1>이 제목이고 <p>가 문단이라는 사실을 자동으로 이해하지 않습니다.
그래서 먼저 HTML 문자열을 해당하는 문서 구조로 해석해야 합니다.
이를 HTML 파싱(Parsing) 이라고 합니다.
scraper에서는 다음 코드 한 줄이면 됩니다.
let document = Html::parse_document(&html);지난 편의 response.text()가 서버의 응답을 문자열로 읽어오는 과정이었다면, 이번 Html::parse_document()는 그 문자열을 실제 HTML 구조로 해석하는 과정이라고 생각하시면 됩니다.
흐름으로 보면 다음과 같습니다.
웹 서버
    ↓
HTTP 응답
    ↓
response.text()
    ↓
String
    ↓
Html::parse_document()
    ↓
탐색 가능한 HTML 문서
이제야 우리가 흔히 웹브라우저의 개발자 도구에서 보는 HTML 구조를 Rust 프로그램에서도 탐색할 수 있게 되었습니다.
우리가 찾을 HTML을 먼저 살펴봅시다
이제 Books to Scrape 사이트에 접속해서 책 하나가 어떤 HTML로 만들어져 있는지 살펴보겠습니다.
웹브라우저에서 다음 사이트를 엽니다.
https://books.toscrape.com/Chrome을 기준으로 책 제목 위에서 마우스 오른쪽 버튼을 누르고 검사를 선택하면, 아래와 같이 개발자 도구에서 해당 HTML을 확인할 수 있습니다.
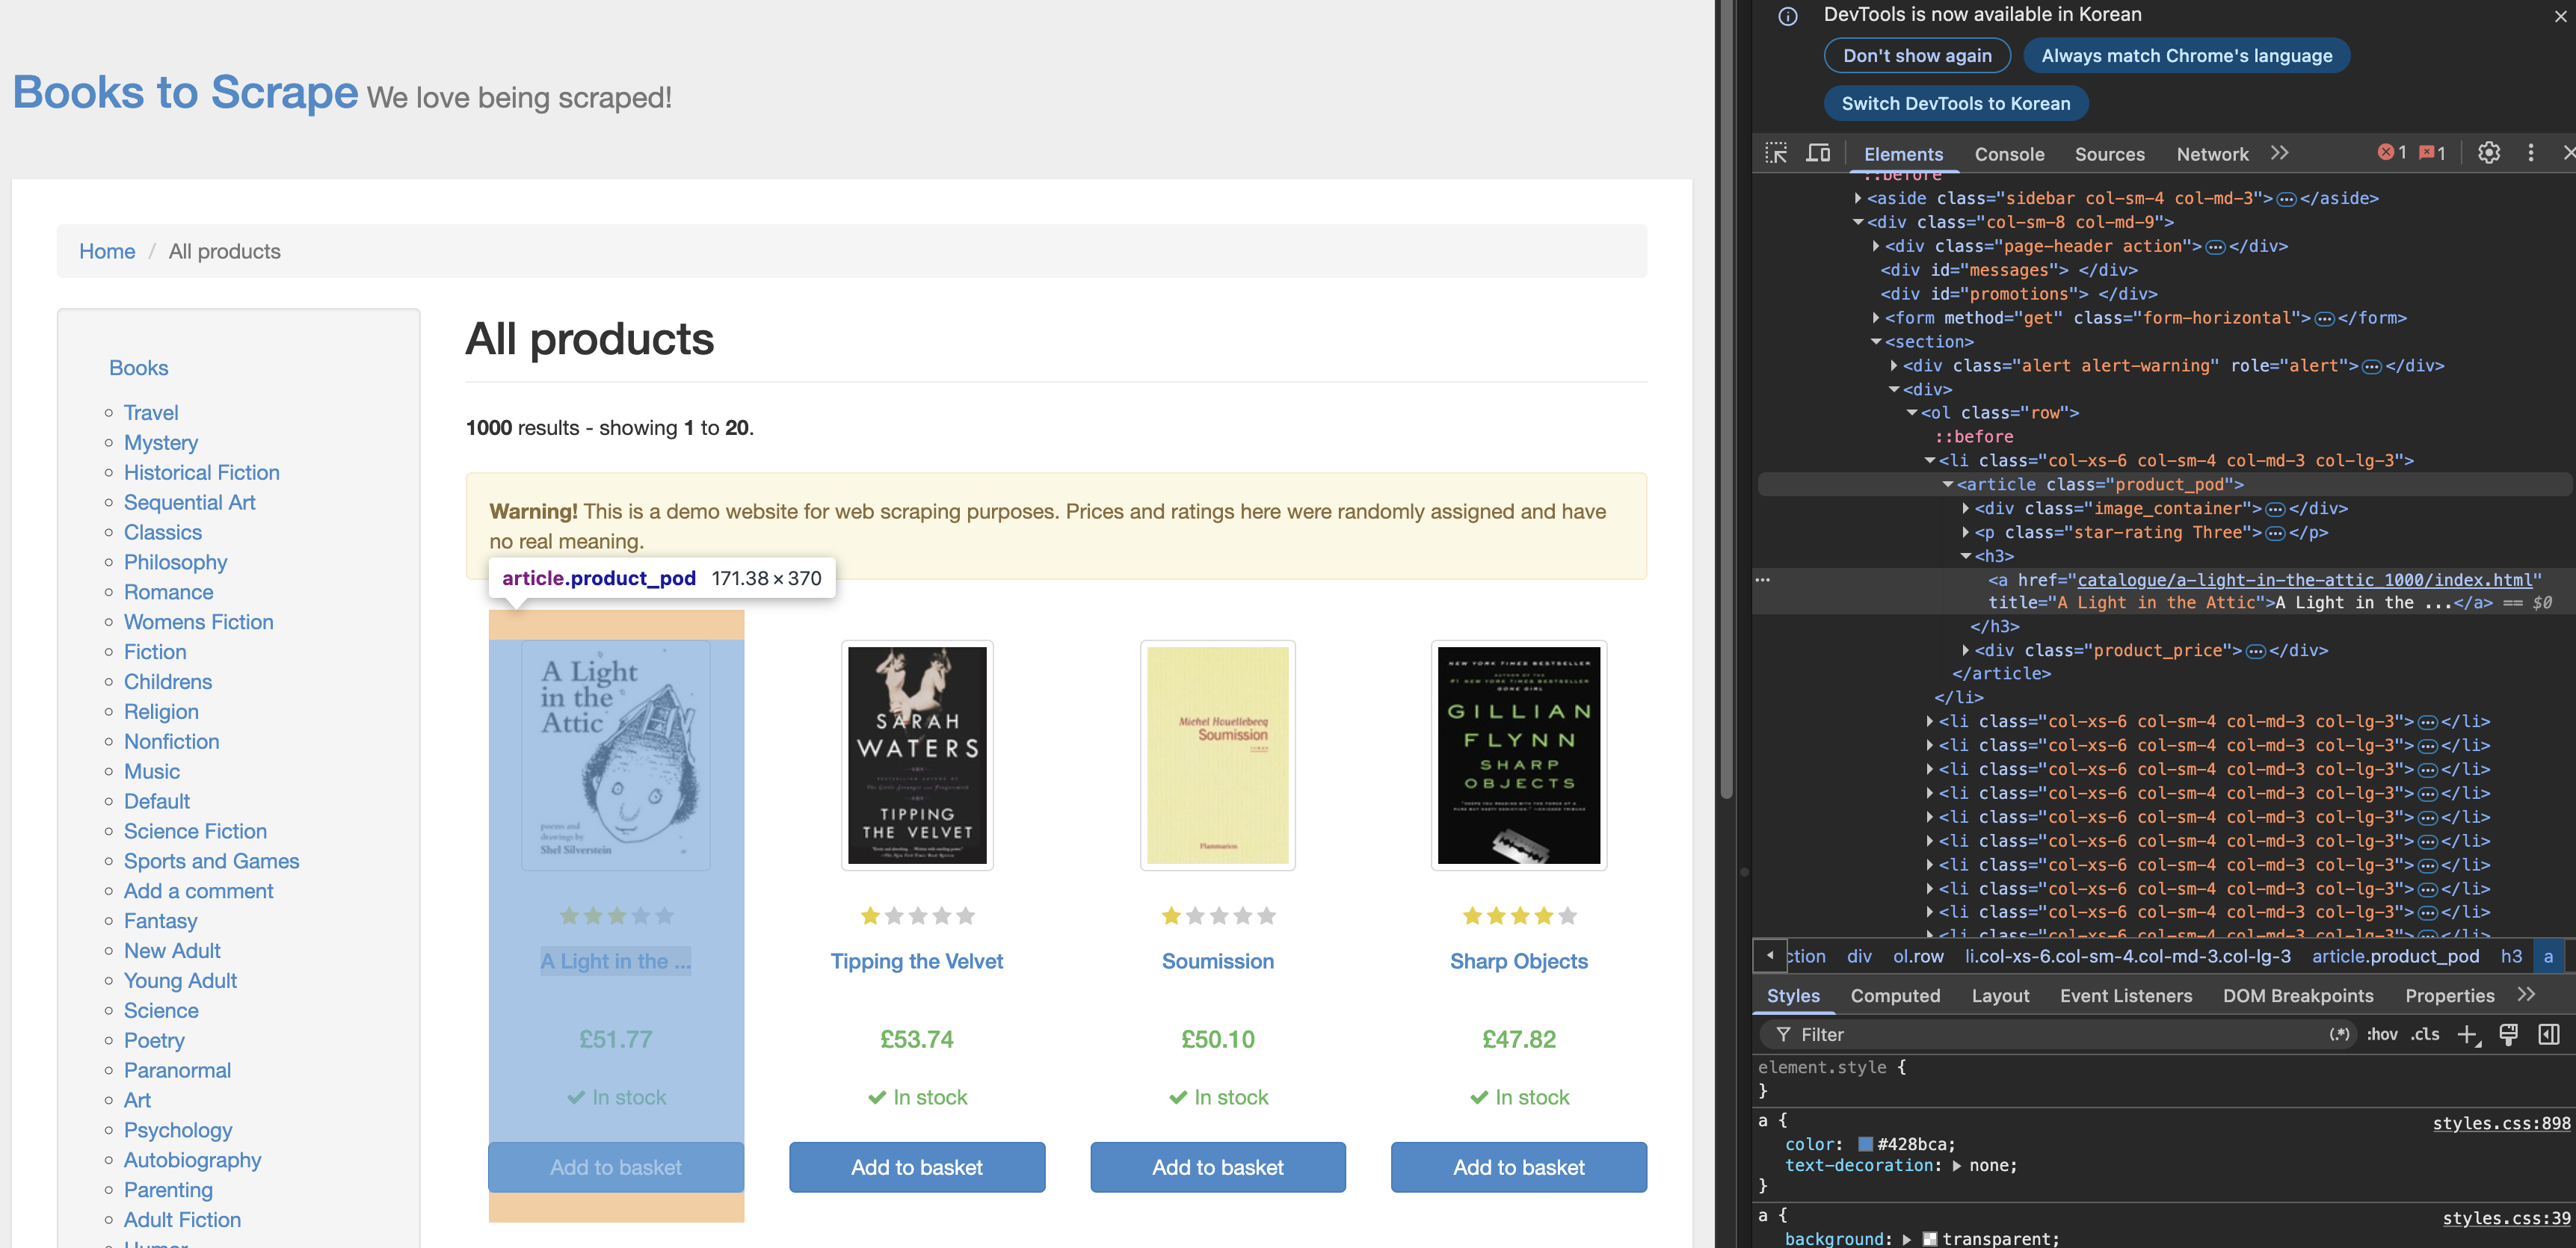
코드를 확인하면 책 하나는 대략 다음과 같은 구조 안에 들어 있습니다.
<article class="product_pod">

    ...

    <h3>
        <a href="catalogue/a-light-in-the-attic_1000/index.html"
           title="A Light in the Attic">
            A Light in the Attic
        </a>
    </h3>

    ...

</article>
여기서 우리가 오늘 원하는 데이터는 두 가지입니다.
A Light in the Attic
catalogue/a-light-in-the-attic_1000/index.html
즉,
책 제목과 해당 책의 상세 페이지 주소입니다.
둘 다 <a> 태그 안에서 얻을 수 있습니다.
CSS 선택자가 등장합니다
HTML에서 원하는 요소를 찾을 때 많이 사용하는 방법 중 하나가 CSS 선택자(CSS Selector) 입니다.
CSS를 조금이라도 다뤄보셨다면 익숙한 문법입니다.
예를 들어,
<p class="price">£29.99</p>라는 HTML에서 price 클래스를 가진 요소를 선택하려면 다음처럼 작성합니다.
.pricep 태그이면서 price 클래스를 가진 요소를 정확하게 지정하려면 이렇게 작성할 수도 있습니다.
p.priceHTML의 계층 구조까지 이용할 수도 있습니다.
article.product_pod h3 a이 선택자를 사람의 말로 풀어보면 대략 이렇습니다.
article 태그 중에서
class가 product_pod인 요소를 찾고

그 안에 있는 h3를 찾은 다음

그 안의 a 태그를 선택
바로 우리가 찾고 있는 책 제목 링크입니다.
Rust에서 CSS 선택자 만들기
scraper에서는 CSS 선택자를 문자열로 바로 사용할 수 없습니다.
먼저 원하는 선택자를 인자로 전달해서 Selector 객체를 만들어야 합니다.
let book_selector =
    Selector::parse("article.product_pod h3 a").unwrap();
여기서 우리가 선택한 대상은 다음 요소입니다.
<a href="catalogue/.../index.html"
   title="A Light in the Attic">
    A Light in the Attic
</a>
이제 document에서 이 선택자와 일치하는 모든 요소를 찾을 수 있습니다.
let books = document.select(&book_selector);select()는 조건에 해당하는 요소 하나만 반환하는 것이 아니라 조건에 맞는 요소들을 차례대로 반환합니다.
Books to Scrape 첫 페이지에는 책이 20권 있으므로 해당 선택자에 일치하는 요소도 여러 개 나오게 됩니다.
따라서 for문으로 하나씩 확인해 보겠습니다.
for book in document.select(&book_selector) {
    println!("{:?}", book);
}
이제 슬슬 스크래퍼다운 냄새가 나기 시작합니다.
책 제목 가져오기
책 제목은 <a> 태그의 title 속성에 들어 있습니다.
다시 HTML을 보면 다음과 같습니다.
<a
    href="catalogue/a-light-in-the-attic_1000/index.html"
    title="A Light in the Attic"
>
    A Light in the Attic
</a>
여기서 title 값을 가져오려면 value()와 attr()을 사용합니다.
let title = book
    .value()
.attr("title");value()메서드를 호출하면 현재 선택한 HTML 요소의 정보를 확인할 수 있습니다.
그리고
.attr("title")attr(속성)메서드를 호출하면 그 요소가 가진 속성값(지금은 title)을 가져옵니다.
다만 여기서 한 가지 중요한 점이 있습니다.
attr()메서드의 결과는 바로 문자열이 아니라 Option입니다.
대략 다음과 같은 의미입니다.
title 속성이 있다
    ↓
Some("A Light in the Attic")

title 속성이 없다
    ↓
None
왜 이렇게 되어 있을까요?
HTML 요소에 우리가 요청한 속성이 반드시 존재한다는 보장이 없기 때문입니다.
예를 들어 다음 HTML에는 title 속성이 없습니다.
<a href="/book/1">
    Rust Book
</a>
그래서 Rust는 그냥 문자열을 돌려주는 대신,
값이 있을 수도 있고 없을 수도 있습니다.
라는 사실을 Option으로 표현합니다.
Rust를 공부하다 보면 정말 지겹도록 만나게 되는 녀석이죠:)
우선 unwrap()으로 값을 확인해봅시다
현재 우리가 연습하고 있는 사이트에서는 책 링크에 title 속성이 들어 있다는 것을 알고 있습니다.
따라서 우선은 간단하게 unwrap()을 사용해보겠습니다.
for book in document.select(&book_selector) {
    let title = book
        .value()
        .attr("title")
        .unwrap();

    println!("{title}");
}
프로그램을 실행합니다.
cargo run정상적으로 동작한다면 첫 페이지의 책 제목들이 차례대로 출력됩니다.
A Light in the Attic
Tipping the Velvet
Soumission
Sharp Objects
Sapiens: A Brief History of Humankind
...
드디어 HTML 전체가 아니라 우리가 원하는 데이터만 프로그램에서 가져오기 시작했습니다.
1편에서 수만 바이트짜리 HTML 덩어리를 통째로 가져왔던 것과 비교하면 상당히 발전했죠?
이번에는 상세 페이지 주소를 가져와봅시다
같은 <a> 요소 안에는 책 제목뿐 아니라 href도 들어 있습니다.
<a
    href="catalogue/a-light-in-the-attic_1000/index.html"
    title="A Light in the Attic"
>
href 속성에 담긴 상세 페이지 주소도 책 제목을 가져온 것과 같은 방식으로 가져올 수 있습니다.
let href = book
    .value()
    .attr("href")
    .unwrap();
제목과 함께 출력해보겠습니다.
for book in document.select(&book_selector) {
    let title = book
        .value()
        .attr("title")
        .unwrap();

    let href = book
        .value()
        .attr("href")
        .unwrap();

    println!("{title}");
    println!("{href}");
}
실행 결과는 대략 다음과 같습니다.
A Light in the Attic
catalogue/a-light-in-the-attic_1000/index.html

Tipping the Velvet
catalogue/tipping-the-velvet_999/index.html

Soumission
catalogue/soumission_998/index.html
우리가 원했던 두 가지 데이터를 모두 얻었습니다.
그런데 이 주소는 조금 이상합니다
출력된 URL을 자세히 보겠습니다.
catalogue/a-light-in-the-attic_1000/index.html우리가 평소에 사용하는 웹 주소와 조금 다릅니다.
보통 주소는 이런 모습이죠.
https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html앞부분의
https://books.toscrape.com/이 빠져 있습니다.
이처럼 프로토콜과 도메인이 생략되고 현재 페이지의 위치를 기준으로 해석되는 주소를 상대 URL(Relative URL) 이라고 합니다. 상대 URL은 /catalogue/...처럼 /로 시작할 수도 있고, 지금 예제처럼 catalogue/... 형태로 시작할 수도 있습니다.
반대로 흔히 볼 수 있는 http:// 등의 프로토콜과 도메인까지 모두 포함하고 있는 주소를 절대 URL(Absolute URL) 이라고 합니다.
상대 URL

catalogue/a-light-in-the-attic_1000/index.html
절대 URL
https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html웹브라우저는 현재 보고 있는 페이지 주소를 알고 있기 때문에 상대 URL만 있어도 알아서 이동할 수 있습니다.
하지만 우리 프로그램은 앞으로 이 주소를 이용해 직접 HTTP 요청을 보내야 합니다.
따라서 상세 페이지를 요청하기 전에 완전한 URL로 만들어주는 과정이 필요합니다.
오늘은 우선 상대 URL을 가져오는 것까지 진행하고, 뒤에 공개할 포스트에서 별도의 함수로 정리해보겠습니다.
지금까지의 코드를 합쳐봅시다
이제 지난 편의 fetch_html()과 오늘 만든 HTML 파싱 코드를 합쳐보겠습니다.
use reqwest::header::USER_AGENT;
use reqwest::Client;
use scraper::{Html, Selector};
const TARGET_URL: &str = "https://books.toscrape.com/";
async fn fetch_html(
client: &Client,
url: &str,
) -> Result<String, reqwest::Error> {
let response = client
.get(url)
.header(
USER_AGENT,
"rust-book-scraper/0.1"
)
.send()
.await?
.error_for_status()?;
response.text().await
}
#[::]
async fn main() -> Result<(), reqwest::Error> {
let client = Client::new();
let html = fetch_html(
&client,
TARGET_URL,
)
.await?;
let document = Html::parse_document(&html);
let book_selector =
Selector::parse("article.product_pod h3 a")
.unwrap();
for book in document.select(&book_selector) {
let title = book
.value()
.attr("title")
.unwrap();
let href = book
.value()
.attr("href")
.unwrap();
println!("{title}");
println!("{href}");
println!();
}
Ok(())
}코드가 조금 길어졌지만 실제 동작 순서는 아주 단순합니다.
1. Client 생성
        ↓
2. 웹페이지 요청
        ↓
3. HTML 문자열 가져오기
        ↓
4. HTML 문서 파싱
        ↓
5. CSS 선택자 생성
        ↓
6. 일치하는 요소 검색
        ↓
7. title과 href 추출
지난 편에서 만든 코드를 버리지 않고 그 위에 새로운 기능을 하나씩 얹고 있다는 점도 중요합니다.
프로그램이 커진다고 해서 매번 처음부터 다시 만드는 것이 아니라, 잘 나누어 놓은 작은 기능들을 계속 조립해 나가는 것입니다.
이번 연재글처럼 실제 프로그램을 만드는 과정을 함께 하는 이유도 이러한 방식들을 익히고 체화하기 위함입니다.
parse_document()를 별도의 함수로 빼볼까요?
지난 편에서 웹페이지 요청 부분을 fetch_html()이라는 함수로 분리했습니다.
HTML에서 책 정보를 가져오는 부분도 마찬가지로 계속 main() 안에 넣다 보면 금방 복잡해집니다.
앞으로는 제목뿐 아니라 가격, 평점, 이미지, 재고 등 훨씬 많은 데이터를 찾아야 합니다.
그래서 이번에도 역할을 조금 나누겠습니다.
먼저 책 제목과 URL을 함께 담을 간단한 구조체를 만들어보겠습니다.
struct BookLink {
    title: String,
    url: String,
}struct는 서로 관련된 여러 데이터를 하나의 객체로 묶을 때 사용할 수 있습니다.
책 하나에는 현재 두 가지 정보가 있습니다.
BookLink
├── title
└── url
예를 들면 다음과 같은 데이터 하나를 표현하는 셈입니다.
title:
A Light in the Attic

url:
catalogue/a-light-in-the-attic_1000/index.html
이제 HTML을 받아 책 목록을 만들어주는 함수를 작성해보겠습니다.
fn parse_book_links(html: &str) -> Vec<BookLink> {
    let document = Html::parse_document(html);

    let selector =
        Selector::parse("article.product_pod h3 a")
            .unwrap();

    let mut books = Vec::new();

    for element in document.select(&selector) {
        let title = element
            .value()
            .attr("title")
            .unwrap()
            .to_string();

        let url = element
            .value()
            .attr("href")
            .unwrap()
            .to_string();

        books.push(BookLink {
            title,
            url,
        });
    }

    books
}
조금 새로운 코드가 많이 나왔습니다.
하지만 하나씩 보면 어렵지 않습니다.
Vec에 책들을 차곡차곡 담기
다음 코드는 빈 Vec을 하나 만듭니다.
let mut books = Vec::new();Vec은 여러 개의 값을 순서대로 저장할 수 있는 Rust의 컬렉션입니다.
쉽게 생각하면 목록이며 다른 언어의 Array, List, Vector 등과 유사합니다.
new() 함수로 생성한 books에는 처음에 아무것도 없습니다.
books

[]
첫 번째 책을 찾으면, push() 메서드로 책 정보 하나를 삽입합니다.
books.push(BookLink {
    title,
    url,
});
다음과 같이 하나가 들어갑니다.
[
    BookLink {
        title: "A Light in the Attic",
        url: "catalogue/..."
    }
]
두 번째 책을 찾으면 또 하나가 추가됩니다.
[
    BookLink { ... },
    BookLink { ... }
]
이 과정을 페이지의 모든 책에 대해 반복합니다.
결과적으로 parse_book_links()는 첫 페이지에서 찾은 모든 책 정보를 하나의 Vec<BookLink>로 반환하게 됩니다.
왜 to_string()메서드가 필요할까요?
아까 단순히 출력할 때는 다음 코드만으로도 충분했습니다.
let title = element
    .value()
    .attr("title")
    .unwrap();
하지만 구조체에 데이터를 저장할 때는 다음처럼 to_string()메서드를 사용했습니다.
let title = element
    .value()
    .attr("title")
    .unwrap()
    .to_string();
이 차이는 Rust의 소유권(Ownership) 과 관련되어 있습니다.
attr()메서드로 가져온 문자열은 원래 HTML 문서 안에 있는 값을 잠시 빌려서 보고 있는 형태입니다.
하지만 우리가 만든 BookLink는 HTML 문서와 관계없이 책 제목을 계속 가지고 있어야 합니다.
그래서 to_string()메서드를 이용해 새로운 String을 만들어 구조체가 직접 소유하도록 합니다.
HTML 문서가 가진 문자열을 잠깐 빌림
        ↓
&str

to_string()
        ↓
새로운 문자열을 만들어 직접 소유
        ↓
String
Rust를 처음 공부할 때 가장 많이 머리를 싸매게 만드는 소유권이 여기서 다시 등장했는데요.
일단 지금은 개념적으로만 배웠던 소유권이 실제 프로그램에서는 이렇게 사용되는구나 하고만 이해하셔도 됩니다.
혹은 좀 더 단순하게
파싱한 데이터를 다른 곳에 저장해서 오래 사용하려면
String으로 만들어주는 경우가 많다.
로만 기억하고 넘어가도 앞으로의 과정이 더 쉬워질 것입니다.
소유권에 대한 더 깊은 이해를 원한다면, 제가 3년 전에 작성한 소유권 설명해드림 시리즈 1편, 2편, 3편을 참고하시기 바랍니다.
수정한 main() 함수
이제 main()에서는 직접 HTML 요소를 찾지 않아도 됩니다.
#[::]
async fn main() -> Result<(), reqwest::Error> {
let client = Client::new();
let html = fetch_html(
&client,
TARGET_URL,
)
.await?;
let books = parse_book_links(&html);
for book in books {
println!("제목: {}", book.title);
println!("주소: {}", book.url);
println!();
}
Ok(())
}이제, 각 함수의 역할이 훨씬 명확해졌습니다.
fetch_html()
    ↓
HTML을 가져오는 역할

parse_book_links()
    ↓
HTML에서 책 정보를 찾는 역할

main()
    ↓
전체 실행 순서를 관리하는 역할
앞으로 기능이 추가될수록 이런 구분은 점점 더 중요해집니다.
이번 편의 완성 코드
지금까지 작성한 코드를 하나로 합치면 다음과 같습니다.
use reqwest::header::USER_AGENT;
use reqwest::Client;
use scraper::{Html, Selector};
const TARGET_URL: &str = "https://books.toscrape.com/";
struct BookLink {
title: String,
url: String,
}
async fn fetch_html(
client: &Client,
url: &str,
) -> Result<String, reqwest::Error> {
let response = client
.get(url)
.header(
USER_AGENT,
"rust-book-scraper/0.1"
)
.send()
.await?
.error_for_status()?;
response.text().await
}
fn parse_book_links(html: &str) -> Vec<BookLink> {
let document = Html::parse_document(html);
let selector =
Selector::parse("article.product_pod h3 a")
.unwrap();
let mut books = Vec::new();
for element in document.select(&selector) {
let title = element
.value()
.attr("title")
.unwrap()
.to_string();
let url = element
.value()
.attr("href")
.unwrap()
.to_string();
books.push(BookLink {
title,
url,
});
}
books
}
#[::]
async fn main() -> Result<(), reqwest::Error> {
let client = Client::new();
let html = fetch_html(
&client,
TARGET_URL,
)
.await?;
let books = parse_book_links(&html);
println!("찾은 책: {}권", books.len());
println!();
for book in books {
println!("제목: {}", book.title);
println!("주소: {}", book.url);
println!();
}
Ok(())
}터미널에서 다시 실행해보겠습니다.
cargo run정상적으로 동작한다면 다음과 같이 첫 페이지에 있는 책들의 제목과 URL이 출력됩니다.
찾은 책: 20권

제목: A Light in the Attic
주소: catalogue/a-light-in-the-attic_1000/index.html

제목: Tipping the Velvet
주소: catalogue/tipping-the-velvet_999/index.html

...
1편에서는 웹사이트의 HTML 전체를 가져오는 데 성공했습니다.
그리고 이번 2편에서는 그 안에서 우리가 원하는 책 목록만 골라낼 수 있게 되었습니다.
웹 스크래핑이라는 작업을 조금 단순하게 바라보면 결국 이 두 가지의 반복이라고 볼 수도 있습니다.
필요한 페이지를 가져오고
        ↓
그 안에서 필요한 데이터를 찾는다
그런데 아직 한 가지 문제가 남아 있습니다.
현재 가져온 책 주소는 다음처럼 상대 URL입니다.
catalogue/a-light-in-the-attic_1000/index.html다음 단계에서는 이 주소를 이용해 각각의 책 상세 페이지에 직접 접속해야 합니다.
그리고 상세 페이지 안으로 들어가면 드디어 가격, 재고, 별점, 상품 설명과 같은 진짜 데이터들을 만날 수 있습니다.
3편 예고: 목록에서 상세 페이지로 들어가기
지금까지 우리가 보고 있던 페이지는 여러 권의 책을 한꺼번에 보여주는 목록 페이지였습니다.
목록 페이지
    ↓
책 1
책 2
책 3
책 4
...
목록 페이지에는 간단한 정보만 들어 있고, 우리가 최종적으로 수집하고 싶은 정보 대부분은 각 책의 상세 페이지 안에 있습니다.
다음 편에서는 오늘 얻은 상대 URL을 완전한 주소로 만들고,
catalogue/a-light-in-the-attic_1000/index.html다음과 같은 상세 페이지 URL로 변환해보겠습니다.
https://books.toscrape.com/catalogue/a-light-in-the-attic_1000/index.html그리고 20개의 주소를 하나씩 순회하면서 실제 상세 페이지의 HTML을 가져와보겠습니다.
1편에서 하나의 페이지에 요청을 보내는 법을 배웠고, 2편에서는 그 페이지 안에서 여러 개의 주소를 찾았습니다.
3편에서는 이 둘을 합쳐서 찾은 주소에 다시 요청을 보내는 구조를 만들어보겠습니다.
슬슬 처음에 그렸던 웹 스크래퍼의 전체 구조가 코드로 연결되기 시작합니다:)
이번 편에서 배운 내용
이번 편에서는 다음 내용을 구현했습니다.
scraper라이브러리 추가- HTML 문자열을 문서 구조로 파싱
- CSS 선택자의 기본 개념
Selector::parse()를 이용한 선택자 생성select()를 이용한 HTML 요소 검색attr()을 이용한 HTML 속성 추출- 책 제목과
href가져오기 - 상대 URL과 절대 URL의 차이
struct를 이용해 관련 데이터 묶기Vec을 이용해 여러 개의 책 정보 저장하기&str을String으로 변환해 데이터 보관하기- HTML 파싱 로직을 별도의 함수로 분리하기
다음 편에서는 오늘 추출한 URL을 이용해 각각의 상세 페이지에 접속해보겠습니다.